
Aanvallers maken nu in ongeveer vijf dagen gebruik van nieuwe kwetsbaarheden (Mandiant, onderdeel van Google Cloud). De gemiddelde organisatie heeft 43 dagen nodig om er één te patchen (Verizon DBIR 2026). Een nieuwe gratis gids legt uit hoe autonome AI-agenten die kloof dichten, en wat veiligheidsleiders moeten eisen voordat ze de productie op de korrel nemen.
TL; DR
- Uitbuiting is nu de voordeur. Het veroorzaakt 31% van de inbreuken (Verizon DBIR 2026), de #1 vector voor initiële toegang, terwijl jaarlijkse pentests naar schatting 90% van de nalatenschap onbeproefd laten.
- Het vermogen is bewezen, niet geprojecteerd. Een autonoom systeem stond in 2025 bovenaan het Amerikaanse klassement van HackerOne (XBOW), en peer-reviewed agenten maakten zonder hulp misbruik van 87% van de eendagsfouten (Fang et al., 2024).
- Continue beats periodiek, meetbaar. Door programmatisch testen is de kans dat teams kritieke problemen binnen drie dagen oplossen 4,5x groter (Cobalt, 2026).
- Het is een AI-agent in je productie. Houd het tegen een balk. Bewijsbare dekking, een onafhankelijke validator, vangrails met explosieradius en een audittrail, of geen deal.
- De economie is voorstander van adoptie. Eén handmatige betrokkenheid van ~$18.000 (schatting van de sector) tegen een gemiddelde inbreuk van $4,44 miljoen (IBM, 2025).
De jaarlijkse Pentest is verouderd voordat deze wordt verzonden
Pentesting is in tien jaar nauwelijks veranderd – maar dat moet wel, omdat aanvallers niet langer volgens een jaarlijks tijdschema werken. Tegen een tegenstander die binnen enkele dagen in beweging komt, zijn de jaarlijkse betrokkenheid, de lange pdf en de fixlijst die bij aankomst muf is, simpelweg te traag:
De krachten die het periodieke model onhoudbaar maakten, komen allemaal naar voren in de sectorgegevens van 2026.
Uitbuiting nam de leiding. Verizons DBIR uit 2026, gebaseerd op meer dan 22.000 bevestigde inbreuken, markeert het keerpunt: misbruik van kwetsbaarheden heeft gestolen inloggegevens ingehaald als de meest gebruikelijke manier om binnen te komen.
De sanering ging de andere kant op. De mediane tijd om een bekende misbruikte fout te patchen steeg van 32 naar 43 dagen, en het aandeel van de CISA KEV-catalogusfouten die daadwerkelijk werden gepatcht daalde van 38% naar 26%.
Aanvallers bewegen in dagen, verdedigers in weken. Google Mandiant-telemetrie schat de gemiddelde time-to-exploit op ongeveer vijf dagen. Cobalt’s State of Pentesting uit 2026 schat de gemiddelde tijd om een risicovolle bevinding op te lossen op 39 dagen, met een kloof van 25x tussen de beste en de slechtste presteerders. Een verdediger op een 43-dagenklok die tegenover een tegenstander staat die een zet in vijf standen doet, beheert dat risico niet, net zoals het achteraf documenteren ervan.
AI heeft het point-in-time-model aan beide kanten doorbroken. Aanvallers gebruiken AI om fouten sneller te vinden en te bewapenen. Je eigen ontwikkelaars gebruiken AI om code sneller te verzenden dan enig menselijk team het kan testen, en Cobalt constateert dat AI/LLM-applicaties 2,7 keer zo vaak risicovolle bevindingen met zich meebrengen als traditionele apps.
Een momentopname die één keer per jaar wordt gemaakt en die een tiende van de nalatenschap bestrijkt, weken te laat afgeleverd, tegen een tegenstander die binnen vijf dagen in beweging komt. Dat is de kloof die agentic pentesting wil dichten.
Eén bug, vier uitkomsten
Hier ziet u hoe het verschil eruit ziet bij een enkele, veel voorkomende aanvalsketen: een IDOR in een geverifieerd accountgebied.
Een aanvaller logt in op een gewoon account, wijzigt de account_id bij een profielupdateverzoek en ontdekt dat de app nooit het eigendom controleert. Ze inventariseren ID’s op grote schaal, herschrijven de e-mailadressen van andere gebruikers, activeren wachtwoordresets en lopen weg met volledige accountovername. Geen CVE. Geen misvormde invoer. Het is gewoon bedrijfslogica dat de app fout zat.
Deze exacte bugklasse heeft in 2019 885 miljoen hypotheek- en eigendomsgegevens blootgelegd bij First American Financial: verander één cijfer in een documentlink, bekijk het bestand van iemand anders.
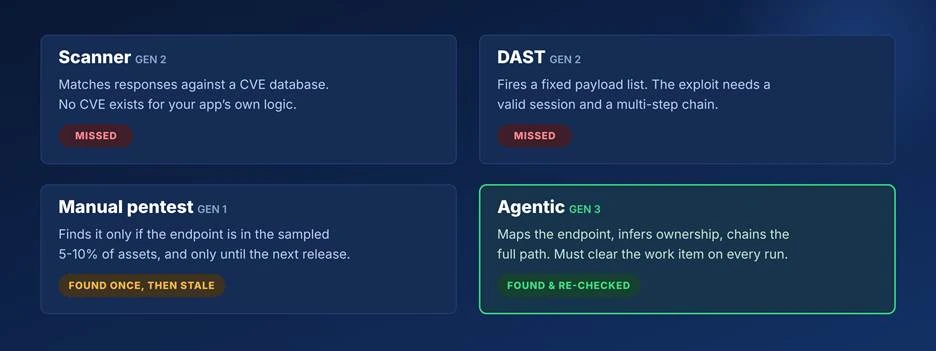
- Een scanner vergelijkt de antwoorden met een CVE-database. Er bestaat geen CVE voor de eigen logica van uw app. Gemist.
- DAST vuurt een vaste payloadlijst af. De exploit heeft een geldige sessie nodig en een uit meerdere stappen bestaande reeks die geen payload-lijst bevat. Gemist.
- Een handmatige pentester vindt het, als dit eindpunt binnen de bemonsterde 5-10% valt, en alleen tot de volgende release. Eén keer gevonden, daarna oud.
- Een agentensysteem brengt het eindpunt in kaart, leidt de eigendomsrelatie af en koppelt de opsomming aan het herschrijven van e-mail tot het opnieuw instellen van het wachtwoord. Dat werkitem moet bij elke run worden gewist. Continu gevonden, gevalideerd en opnieuw gecontroleerd.
Ontdek de volledige vergelijkings- en leveranciersevaluatiecriteria van drie generaties in de CISO-gids, inclusief de tien vragen die een verpakte LLM blootleggen.
Drie ontwerpkeuzes die platforms scheiden van demo’s
De faalmodus van de categorie is DAST met een LLM eraan vastgeschroefd: dezelfde vaste payload-lijst eronder, met een niet-deterministische dekking erbovenop. Wat een platform scheidt is de architectuur, niet de modelkeuze, en dit komt op drie plaatsen naar voren.
- Door werkitems afgedwongen dekking. Als de AI besluit wat te testen, wordt de dekking onbewijsbaar: het model drijft af op interessante bevindingen en slaat stilletjes de rest over. Eis een volledige testmatrix die vooraf wordt gegenereerd, elk eindpunt tegen elke toepasselijke aanvalscategorie, als werkitems die niet kunnen worden overgeslagen. De AI moet adaptief zijn in de manier waarop hij elk item aanvalt, en nooit in de vraag of dat wel het geval is.
- Een onafhankelijke validatoragent. Een bevinding mag pas in het rapport worden opgenomen nadat een afzonderlijke agent deze heeft gereproduceerd. Dat verplaatst de eliminatie van fout-positieven naar de architectuur in plaats van naar de triage-wachtrij van uw team, de verborgen belasting die ervoor zorgt dat veel scantools netto-negatief worden op analistentijd.
- Een browser-native agent. De meeste agentische gereedschappen zijn effectief gekruld met een model eraan bevestigd. Echte websites overtreden ze: dynamische weergave, eenmalige toegangscodes, MFA, anti-botverdediging. De agent moet een echte browser aansturen, de sessiestatus vasthouden en de intentie van de gebruiker reconstrueren, anders wordt de bedrijfslogica onder de oppervlakte niet getest.
“80% dekking is niet langer goed genoeg, omdat aanvallers alleen dat ene gat nodig hebben dat je hebt gemist.” — Ysrael Gurt, CTO en mede-oprichter, Reflectiz
Bestuur het als de autonome agent die het is
Een agentic pentesting-tool is twee dingen tegelijk: een controle die de risico’s vermindert, en een autonoom AI-systeem dat tegen uw eigen omgeving werkt. De governancechecklist van de gids beschrijft wat er nodig is vóór de eerste geautoriseerde run: expliciete en herroepbare scoping, vangrails met een onmiddellijke veilige stop, data-isolatie zonder toegang tot de infrastructuur voor klantgegevens, een volledig exporteerbaar audittraject, gedefinieerd menselijk toezicht en leveranciersgarantie.
De test is eenvoudig. Als u niet kunt antwoorden: “Wat is het ergste dat deze agent met de productie kan doen, en wat houdt deze tegen?” u bent nog niet klaar om een run toe te staan.
De begrotingswiskunde en het auditdividend
Een handmatige betrokkenheid kost gemiddeld ~$18,3K, vóór de gebruikelijke overschrijding van 30-50%, en een volwassen programma besteedt nog steeds $150K+ per jaar om naar schatting 5-10% van zijn activa te testen (Reflectiz-kostenanalyse van gepubliceerde leveranciersprijzen). De vraag voor het bestuur is niet welke offerte het goedkoopst is. Waar het om gaat is de voor de dekking aangepaste risicoreductie per dollar: agentische platforms rapporteren tot tien keer de testcapaciteit ten koste van één handmatige inzet, en elk eindpunt dat continu wordt gedekt, is een pad minder naar een inbreuk van zeven cijfers.
Er is ook een nalevingsdividend. Continu, gedocumenteerd testen levert het bewijs voor de ‘after significant change’-clausules in PCI DSS 4.0.1 die jaarlijks testen structureel niet mogelijk is, en is gekoppeld aan controle- en borgingsactiviteiten onder DORA, NIS2, SOC 2, ISO 27001, AVG artikel 32 en HIPAA. Elke run genereert zijn eigen bewijspakket: een dekkingsmatrix, gevalideerde bevindingen met reproductiestappen en trendrapportage die uw auditors kunnen opvragen. De gids brengt elk raamwerk in kaart met het bewijsmateriaal dat voortdurend testen oplevert.
Wat staat er in de volledige gids
- De blootstellingsgegevens voor 2026, gevisualiseerd
- De tien vragen van leveranciers, met de rode vlaggen die ingepakte LLM’s blootleggen
- De governancecontroles die in het contract moeten worden vastgelegd
- Het landschap van agentische pentesting-leveranciers in kaart gebracht
- Vier prijsmodellen, en wat elk ervan straft
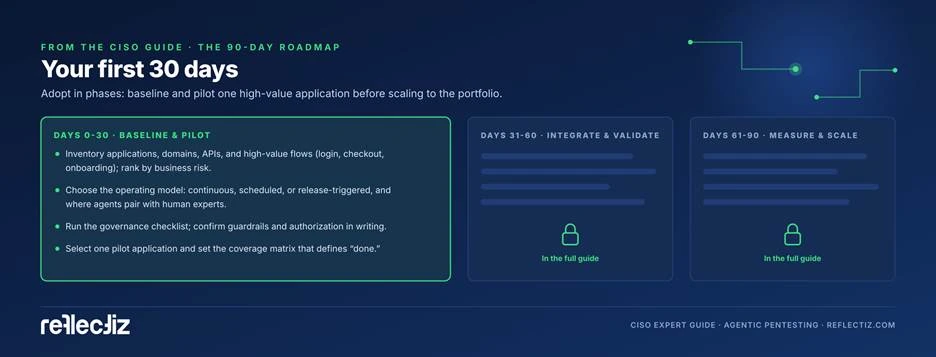
- Een adoptieroadmap van 90 dagen met de KPI’s om het verantwoordelijk te houden
- De 11-punts CISO-checklist
De strategische vraag is voorbij handmatig versus geautomatiseerd gegaan. Waar het nu om gaat is hoe u een continue, aantoonbare, gevalideerde dekking krijgt voor uw hele webportfolio, veilig en tegen een prijs die u kunt verdedigen.
Download hier de Expert Guide to Agentic Pentesting van de CISO.
