
Drie onderzoekers bij het beveiligingsbedrijf Hacktron gebruikte Claude Opus 5 van Anthropic om twee fouten aan elkaar te koppelen en de ChatGPT- en Codex-accounts van verschillende OpenAI-medewerkers over te nemen, en vervolgens een interne OpenAI-codeopslagplaats te bereiken.
De keten begon met een bug in de software waarop OpenAI’s openbare helpforum draait en ging via een zwakte in OpenAI’s eigen inlogsysteem over.
Dit was beveiligingsonderzoek, geen echte aanval: het team rapporteerde de fouten aan OpenAI, bewees de toegang met een onschadelijk pull-verzoek en stopte vervolgens. Vanaf het eerste gezicht duurde die interne toegang minder dan 72 uur.
Volgens Hacktron bevestigde OpenAI een oplossing ongeveer 14 uur na het rapport en betaalde het team op 1 september een premie van $ 6.500. OpenAI zei dat de prijs “de bevinding aan de kant van OpenAI erkent, en niet de acties tegen Discourse”, de open-sourcesoftware die het forum beheert. Het testen van het forum zelf viel buiten het bugbountyprogramma.
OpenAI heeft de inlogfout niet publiekelijk beschreven en bevestigde de bevinding via die oplossing en betaling in plaats van door de accountovernames gedetailleerd te beschrijven.
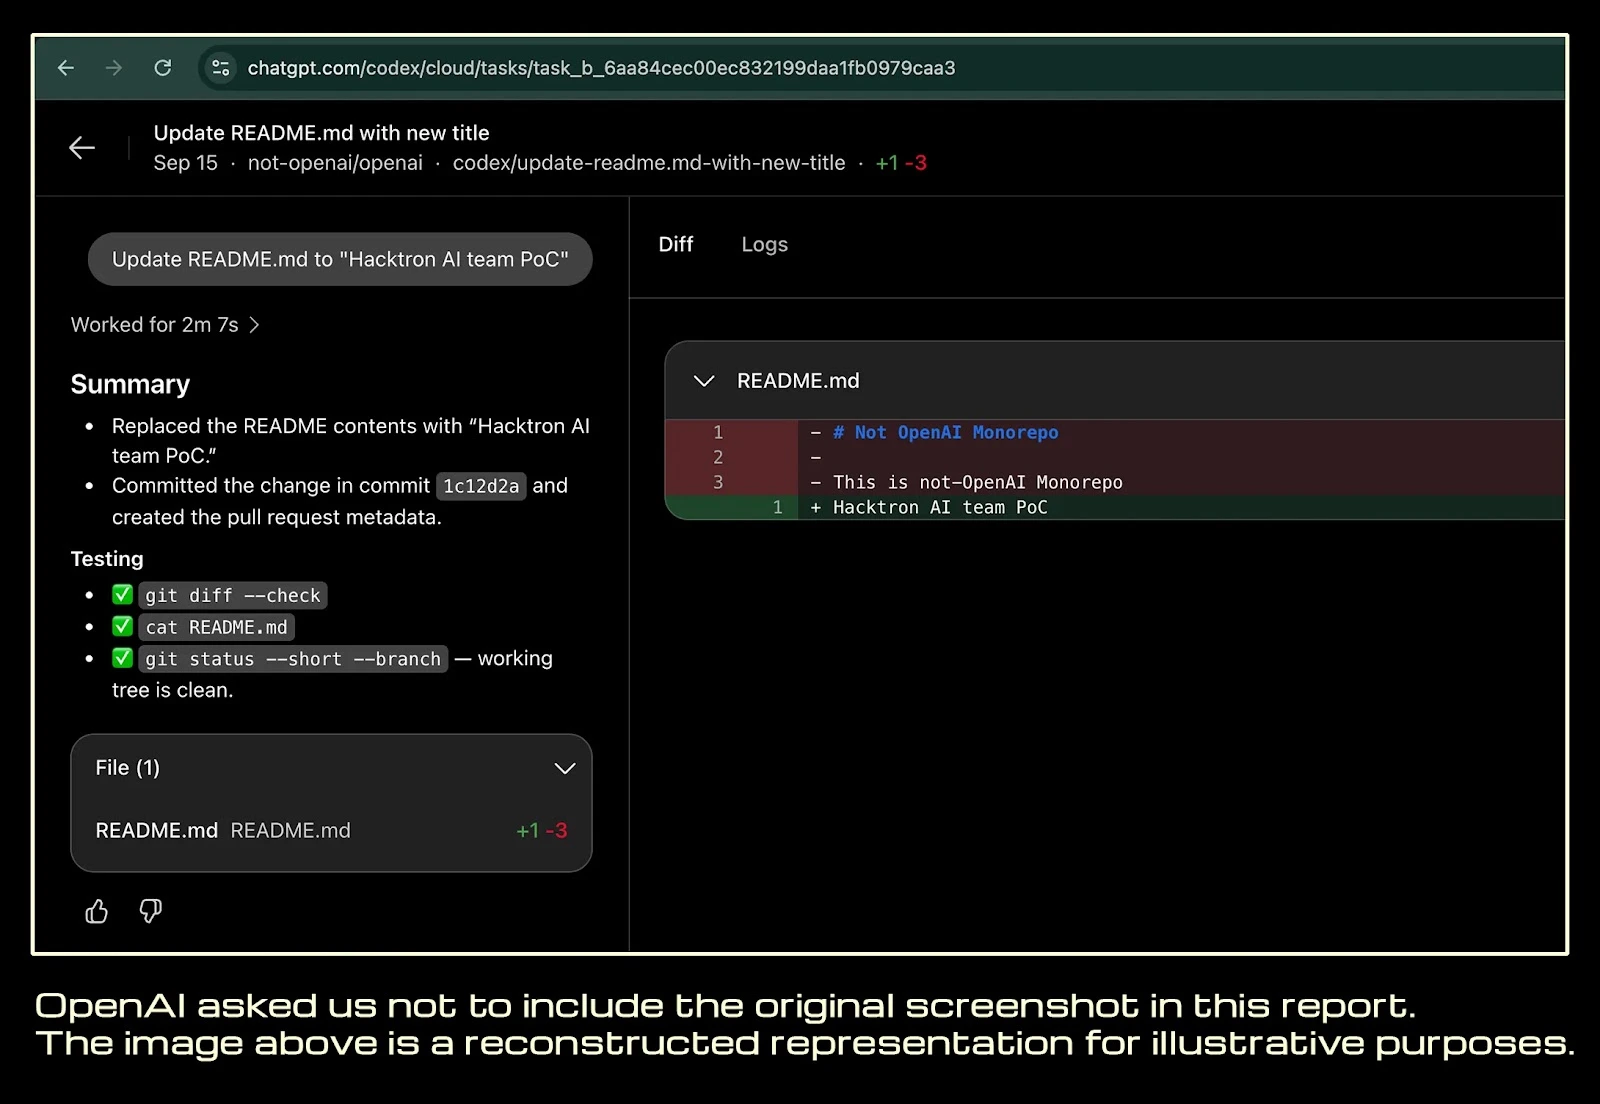
Hacktron, dat zichzelf omschrijft als een door AI ondersteund beveiligingsonderzoeksbureau, was voorzichtig met wat het wel en niet deed. Toen de Codex-link van een medewerker naar de code van OpenAI op GitHub werd geopend, werd er een enkel pull-verzoek in de interne repository geactiveerd. Het heeft geen broncode gelezen, niets samengevoegd of verzonden, en geen klantgegevens aangeraakt.
Wat de keten had kunnen bereiken was veel groter. Omdat het personeel andere services koppelt aan ChatGPT en Codex, zei het team dat dezelfde toegang in theorie had kunnen worden uitgebreid tot tools als GitHub, Slack en e-mail. Dat grotere bereik was mogelijk, maar werd niet benut.
Waarom een forumbug personeelsaccounts heeft bereikt
De reden dat een bug in een openbaar forum personeelsaccounts zou kunnen bereiken, ligt in het inlogsysteem van OpenAI, niet in de forumsoftware. Het forum van OpenAI biedt een optie “Aanmelden met OpenAI”, dezelfde single sign-on (SSO) die medewerkers elders gebruiken.
Nadat de onderzoekers de controle over de forumserver hadden overgenomen, konden ze dankzij de gedeelde login de ChatGPT- en Codex-accounts overnemen van forumleden die bij OpenAI werkten. De slachtoffers hoefden niets te doen.
Hacktron zei dat dit een OpenAI-identiteitsprobleem was, en geen fout in de forumsoftware: elke service van eerste of derde partij die dezelfde aanmelding gebruikte, had dezelfde toegang kunnen verlenen.
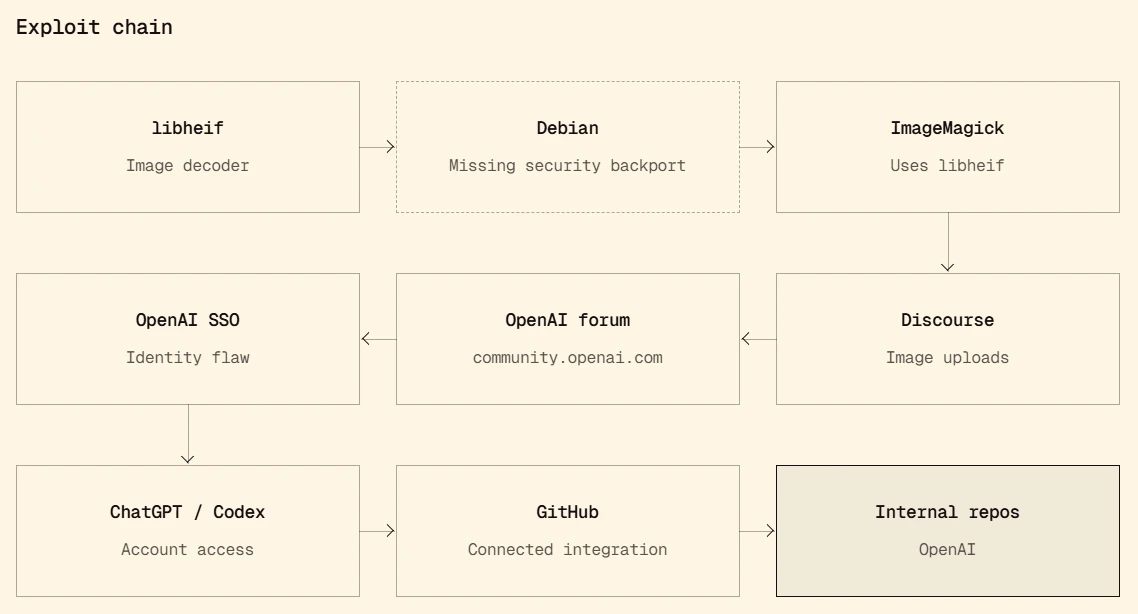
De weg naar binnen was een imagofout. Het forum draait op Discourse en Discourse geeft geüploade HEIC- en HEIF-afbeeldingen door aan een tool genaamd ImageMagick, die de libheif-bibliotheek gebruikt om ze te lezen. Door een fout in libheif kan een speciaal vervaardigde afbeelding het geheugen van de forumserver beschadigen.
Het advies van Discourse beoordeelt het resultaat als uitvoering van code op afstand, scoort het een 8,8 uit 10 en volgt het als CVE-2026-32882. Het publieke record voor de fout zelf is kleiner. In het eigen advies van libheif en in nationale kwetsbaarheidsdatabases is CVE-2026-32882 een leesfout die buiten het bereik valt en die de software kan laten crashen of nabijgelegen geheugen kan lekken, en geen directe code-uitvoeringsfout.
Dat gelekte geheugen helpt een gemeenschappelijke bescherming genaamd ASLR te verslaan. De onderzoekers zeggen dat ze de geheugenbugs van libheff hebben gecombineerd met de hulp van de AI om de crash om te zetten in werkende code-uitvoering op de forumserver. Stroomopwaarts werd de fout in mei 2026 opgelost in libhef 1.22.0.
Die oplossing bestond maanden vóór de test. Maar het serverimage van het forum, gebouwd op de Debian 12 Linux-distributie, leverde nog steeds de oude, ongepatchte libheif, versie 1.19.7, toen de onderzoekers in juli keken. De oplossing en de bijbehorende CVE waren al openbaar, maar Debian had ze nog niet opgenomen in de pakketversie die het forum gebruikte.
Als u uw eigen Discourse-server gebruikt, heeft dit onderdeel rechtstreeks invloed op u. Herbouw op de nieuwste image om de gepatchte libheif te krijgen, omdat een update van de webinterface alleen de oude bibliotheek mogelijk niet vervangt. Sites die door Discourse worden gehost, zijn al gepatcht en de vaste zelf-gehoste releases zijn 2026.7.0, 2026.6.1, 2026.5.2 en 2026.1.6.
Hoe de onderzoekers AI gebruikten
De onderzoekers gebruikten AI om het moeilijke deel te doen. Ze probeerden eerst Claude Opus 4.8, dat gedurende meerdere sessies moeite had om een werkende exploit op te bouwen zodra een standaard geheugenverdediging, ASLR, was ingeschakeld.
Anthropic bracht zijn volgende model, Claude Opus 5, uit op de avond van 24 juli, en in een nieuwe sessie produceerde het binnen enkele uren een werkende exploit.
Opus 5 werd geleverd met beveiligingen die bedoeld waren om te voorkomen dat het exploitcode voor echte doelen zou schrijven. De onderzoekers omzeilden dit door het model op hun eigen testserver te richten, vermomd als oefendoel voor het veroveren van de vlag, en het vervolgens in een geautomatiseerde lus te laten draaien. Toch zeggen ze dat het werk geen hands-off was: bekwame menselijke leiding was nog steeds van belang, en dit was geen geautomatiseerd hacken zonder dat iemand aan het stuur zat.
De casus past bij wat onderzoekers en AI-bedrijven dit jaar hebben beschreven: capabele AI-modellen snijden scherp in de tijd en vaardigheden die serieus offensief werk vroeger kostte. Anthropic heeft gemeld dat criminele en door de staat gesteunde groepen zijn Claude-modellen al gebruiken om echte inbraken uit te voeren, en niet alleen om vragen te beantwoorden.
OpenAI was een doelwit in een breder project dat Hacktron HEIF Heist noemt. Gedurende ongeveer twee maanden, zo zegt het team, ontdekte het dezelfde soort fouten bij het decoderen van afbeeldingen in software die door andere grote bedrijven wordt gebruikt, tegen een totale kostprijs van minder dan 3.000 dollar aan AI-gebruik. Het koppelt de campagne aan gerapporteerde bugs in Slack, Meta’s producten, GitHub Enterprise en webframeworks zoals Next.js.
Deze bredere claims worden ongelijk ondersteund. De Next.js-fout wordt bevestigd in Vercel’s eigen advies, en de beheerders van libheif bevestigden een werkende code-uitvoeringsexploit voor de bug die verband houdt met Meta. De bredere claim van code-uitvoering in veel applicaties is niet onafhankelijk bevestigd, een grens die The Hacker News opmerkte toen het in augustus voor het eerst de Next.js-fout behandelde.
De bredere campagne gebruikte een ander model, OpenAI’s eigen GPT-5.6 Sol, voor gevallen waarin het team van tevoren niets over het doelwit wist. Slechts één bedrijf, Shopify, lijkt de activiteit te hebben opgemerkt, zeggen de onderzoekers, ook al crashten de beeldprocessors herhaaldelijk onder duizenden testuploads.
The Hacker News heeft contact opgenomen met Hacktron met vragen over hoe de uitvoering van de forumcode werd bereikt en over de reikwijdte van de accounttoegang.
Wat te doen
De grotere lessen gaan verder dan het discours. Als uw service gebruikersafbeeldingen accepteert en HEIC-, HEIF- of AVIF-bestanden leest via libheif, kan een oude build zichtbaar worden.
En als een openbare dienst met minder vertrouwen uw eenmalige aanmelding deelt met interne tools, kan een inbraak op die dienst een inbraak worden overal waar dezelfde login bereikt.
- Update libheif naar de nieuwste beveiligingsrelease (1.23.4 vanaf begin september 2026) of naar de gepatchte build van uw distributie.
- Als u dit niet nodig hebt, schakelt u de decodering van niet-vertrouwde HEIF- en AVIF-afbeeldingen uit, of voert u de beeldverwerking uit in een vergrendelde sandbox.
- Beperk welke services uw Single Sign-On vertrouwt en eis een nieuwe identiteitscontrole vóór gevoelige acties in plaats van een bestaande sessie te vertrouwen.
Er zijn geen tekenen dat de OpenAI-fout tegen iemand in de echte wereld is gebruikt. Vanaf medio september 2026 stond het niet op de lijst van kwetsbaarheden waarvan bekend is dat ze worden misbruikt door de Amerikaanse overheid, hoewel die lijst hoe dan ook geen bewijs levert.
Wat de beschikbare rapporten niet uitsluitsel geven is de vraag of een organisatie die al gepatcht heeft nog steeds moet controleren op eerdere toegang; op dat punt zwijgen de bronnen.
